 GENSHI AI
2026年5月に公開した「ローカルLLMとその動作マシン完全ガイド」の、アップデート版です。
前回は、MacとDGX Sparkを比べながら、ユニファイドメモリの仕組みと、量子化したモデルがメモリに載るかどうかが大事だという話をしました。
先日、5月の記事をXで紹介したところ、内容が正確ではないと議論を呼びました。読み返すと、価格もマシンも、紹介したモデルも古くなっていました。AIの進化は早く、半年前の記事でも嘘になってしまいます。
この半年で、価格もマシンもモデルも、推論ソフトも大きく変わりました。10月19日時点の国内価格と手元での実測をもとに、選び方をしっかり見直しました。
(GENSHI AI 代表 長嶋)
推論エンジンStrataで変わったこと
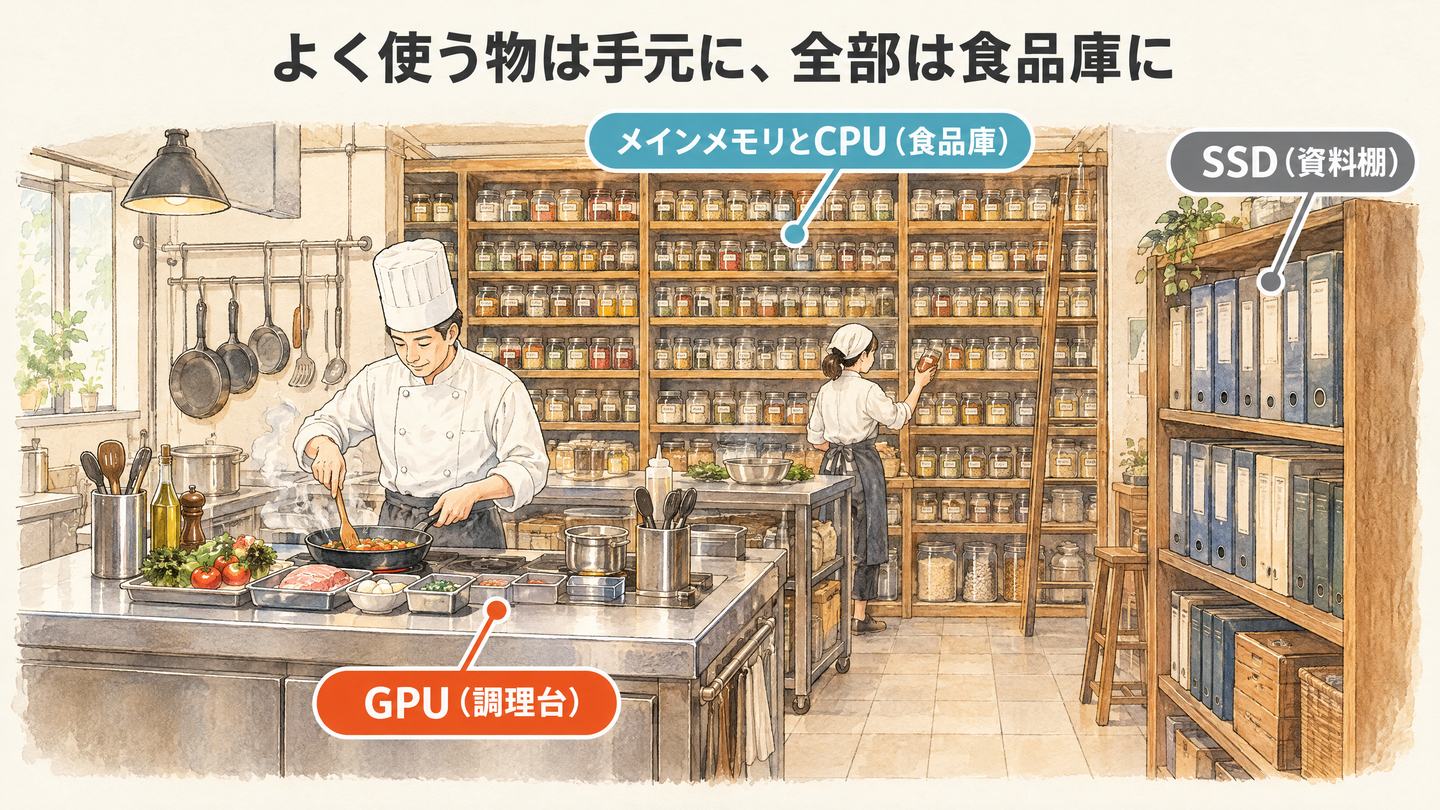
この半年でいちばん大きな変化は、9月に公開されたオープンソースの推論エンジンStrataです。VRAM 12GBのゲーミングGPUと64GBほどのメインメモリで、1,250億パラメータ級のQwen3.8-Flash-Nextが実用的な速さで動きます。半年前なら、128GB以上のユニファイドメモリを持つDGX SparkかMacが必要だったクラスのモデルです。llama.cppで同じモデルを動かすより数倍速く、10月からはMacでも試験的に動くようになりました。10月19日のv0.2.0-betaではWindows、Linux、Mac向けのアプリになり、NVIDIAとAMDのGPUでは画像の読み取りも標準でオンになりました。
Strataは、Qwen3.8-Flash-Nextが1トークンごとに一部のエキスパート(専門家)しか使わないことを利用して、仕事を3か所に分けています。
- GPU(調理台):よく使うエキスパートだけを置きます。
- メインメモリ(食品庫):エキスパートを全部置き、GPUにないものはCPUがその場で計算します。
- SSD(資料棚):大きな参照表を置き、必要な行だけ読みます。
VRAMが小さくても動かせはしますが、制限はいろいろあります。動くのはQwen3.8-Flash-Nextとその派生版(とQwen3.6-35B-A3B)だけで、標準では1度に1件ずつしか処理しません。いまはメモリ自体も高いので、すでにGPUを持っていて、メモリが64GBある人や、ある程度買い足せる人なら、選択肢の一つになります。
用途別のおすすめ構成と予算
| 用途 | ハードウェア | ソフトウェア | 予算の目安(税込) |
|---|---|---|---|
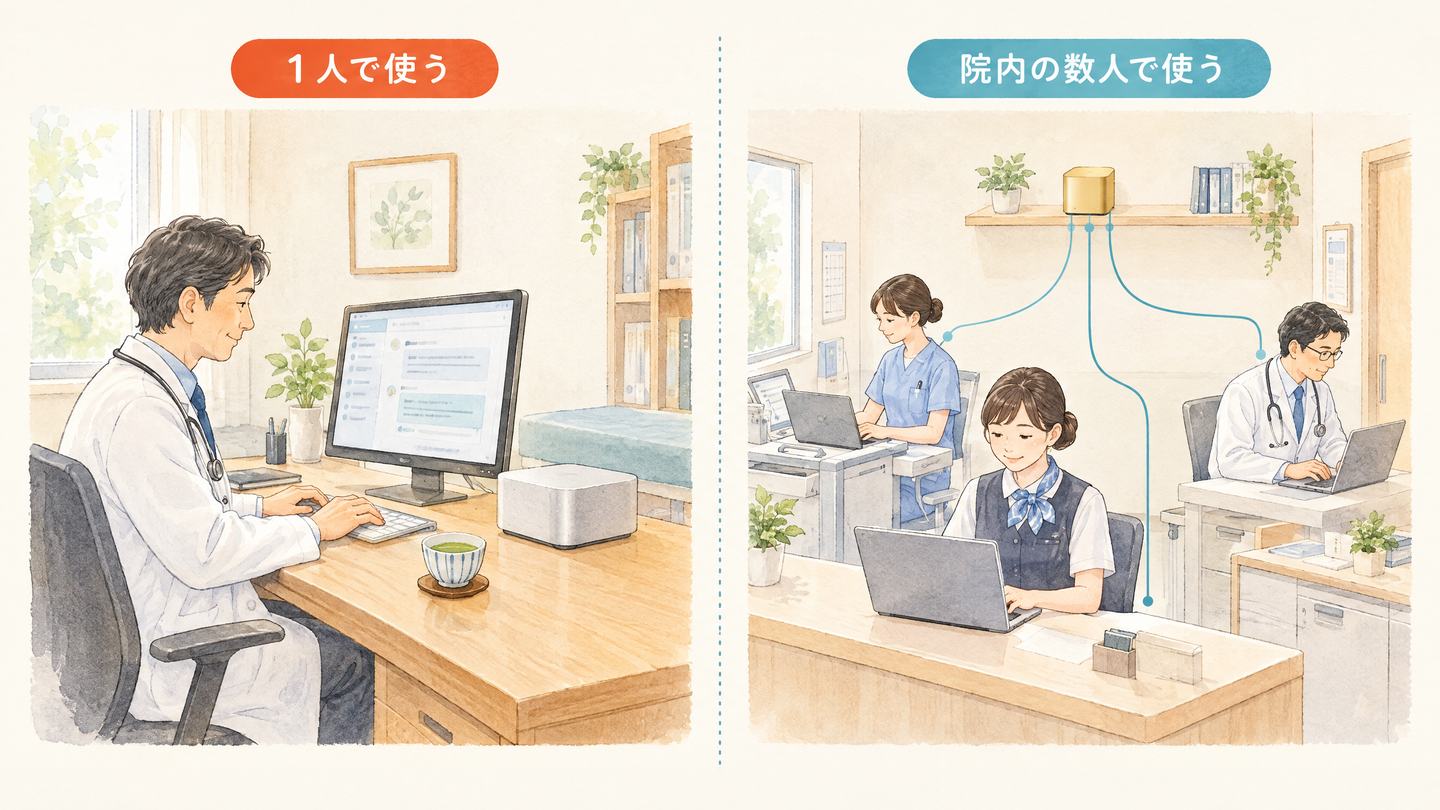
| 1人で毎日使う | Mac Studio M5 Max 128GB | Strata | 887,800円 |
| 長い文書を快適に扱う | Mac Studio M5 Ultra 256GB | MLX、Strata | 1,669,800円 |
| ゲーミングPCを持っている | 手持ちのPC(VRAM 12GB以上)+メモリ64GB | Strata | メモリの増設で約10万円 |
| 院内の数人で使う | DGX Spark 128GB(GB10搭載機) | vLLM | 1,079,980円から |
| 十数人以上で使う | RTX PRO 6000 Blackwell(96GB)のサーバー | vLLM | GPUだけで約279万円から |
私の手元には、MacとDGX Sparkの両方があります。LLMを動かすのが目的なら、一般の方に勧めるのはMacです。M5世代で長い文書の読み込みが大きく速くなり、128GBあればStrataでQwen3.8-Flash-Nextが快適に動きます。
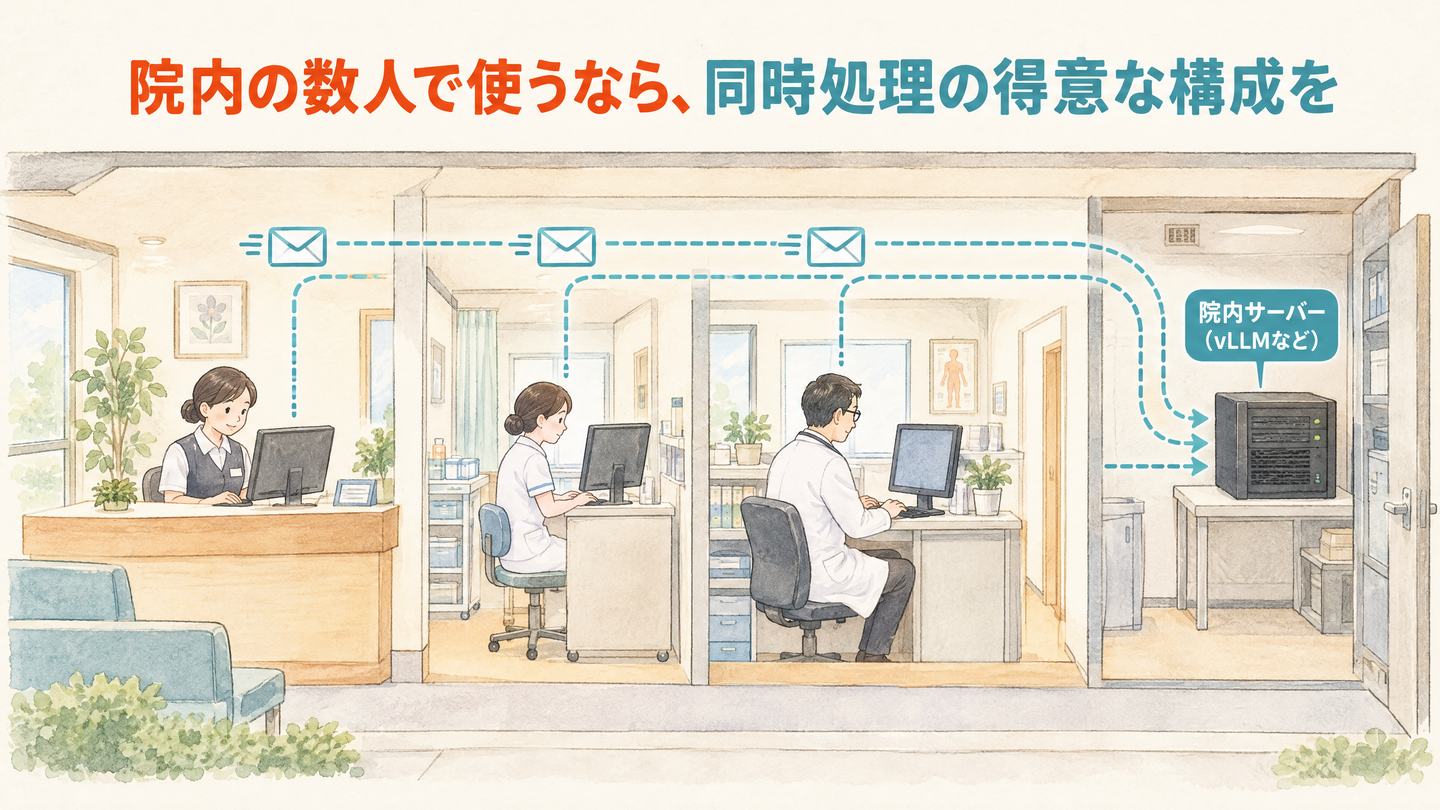
DGX Sparkが活きるのは、CUDAが要る場面です。小さな学習を回したり、画像生成や音声認識などLLM以外のモデルを動かしたりするなら、DGX Sparkのほうが向いています。院内の数人で同時に使う場合も、同時に来た依頼をまとめて処理するvLLMがそのまま動くDGX Sparkが合っています。vLLMは、MacのGPUには公式に対応していません。
10月23日に出る64GB版は、Qwen3.8-Flash-Nextが載らないため、1台で大きなモデルを動かす用途には向きません。
主なハードウェアの比較
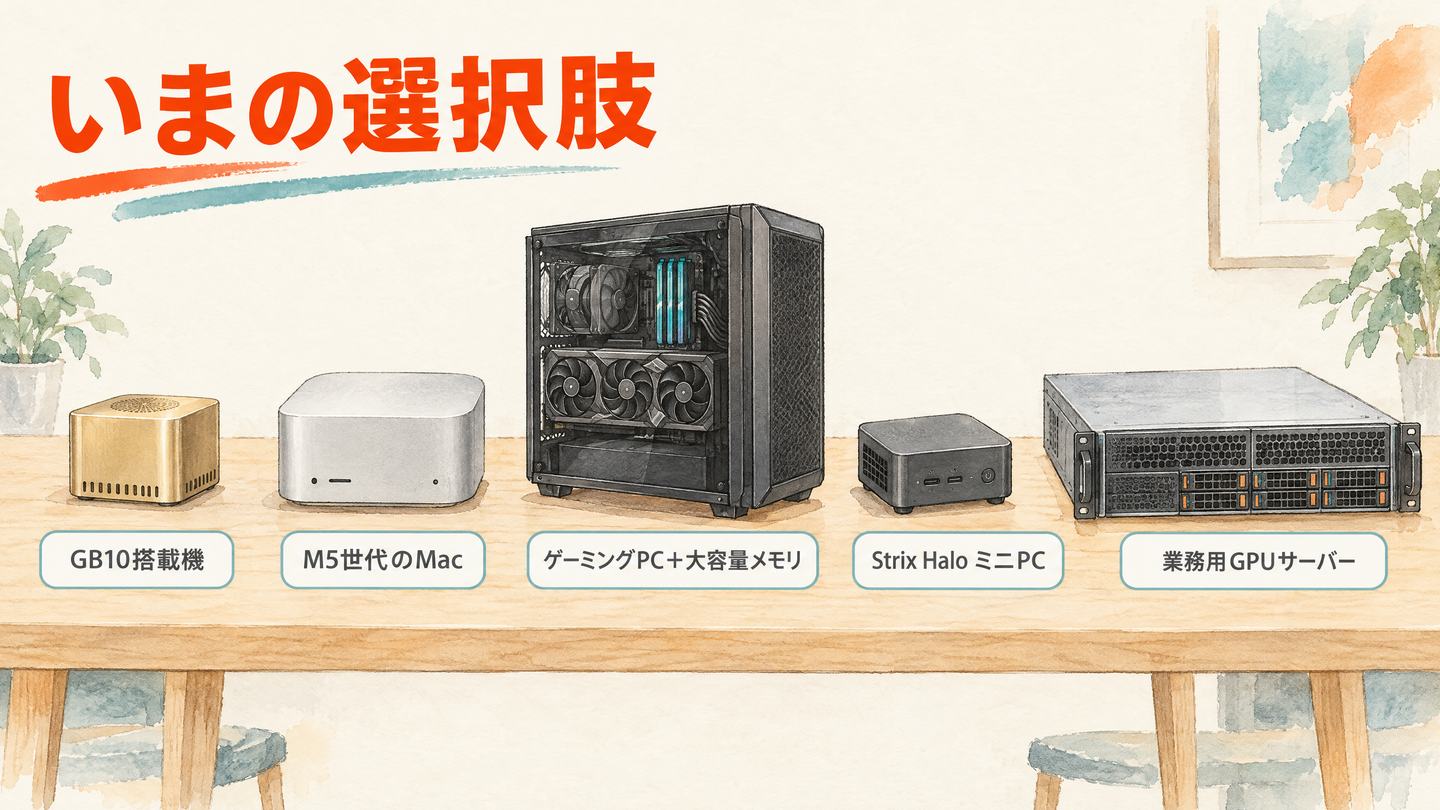
AI向けのデータセンターがメモリを大量に買い、パソコン用のメモリが足りなくなっています。この半年で、ローカルLLM向けのマシンはほぼすべて値上がりしました。DGX Sparkの米国価格は、発売時の3,999ドルから6,950ドルまで上がったと報じられています。
Qwen3.8-Flash-Nextを動かしたときの目安です。
| マシン | メモリ(帯域幅) | 国内価格(税込) | 生成速度(tok/s) | 所見 |
|---|---|---|---|---|
| Mac Studio M5 Ultra | 256GB(1.2TB/s) | 1,669,800円 | 108 | いちばん快適。4bit版でも余裕 |
| Mac Studio M5 Max | 128GB(614GB/s) | 887,800円 | 95〜100(Strata) | 1人で使う最有力候補 |
| DGX Spark(GB10搭載機) | 128GB(273GB/s) | 1,079,980円から | 約44(4bit) | 数人で同時に使う候補。空きメモリはわずか |
| DGX Spark 64GB版 | 64GB(273GB/s) | 未発表 | 載らない | 30B前後のモデル向け |
| RTX 5070+DDR5 64GB | VRAM 12GB+RAM 64GB | GPUとメモリで約25万円 | 53(Strata) | ゲーミングPCを持っている人向け |
| Ryzen AI Max+ 395搭載機 | 128GB(256GB/s) | 566,999円から | 42〜59(Strata) | 安い128GB機。Linuxに慣れた人向け |
| Mac Studio M3 Ultra(当社実測) | 96GB(819GB/s) | 販売終了 | 約70(Strata) | 手元にあれば十分。長文だけ待ちが長め |
| RTX PRO 6000 Blackwellのサーバー | VRAM 96GB(GDDR7) | GPUだけで約279万円から | 未確認 | 大人数で使う本格的な構成 |
出典:M5 UltraはMacStories(oMLX、4bit)、M5 MaxとRTX 5070はStrata公式、DGX SparkはNVIDIAのフォーラムの報告(Strataは使わず、4bit中心の構成で1件ずつ処理)、Ryzen AI Max+ 395は利用者の報告(HP ZBook Ultra G1a、70W)です。
ハードウェア別の解説
1. DGX Spark(128GB)
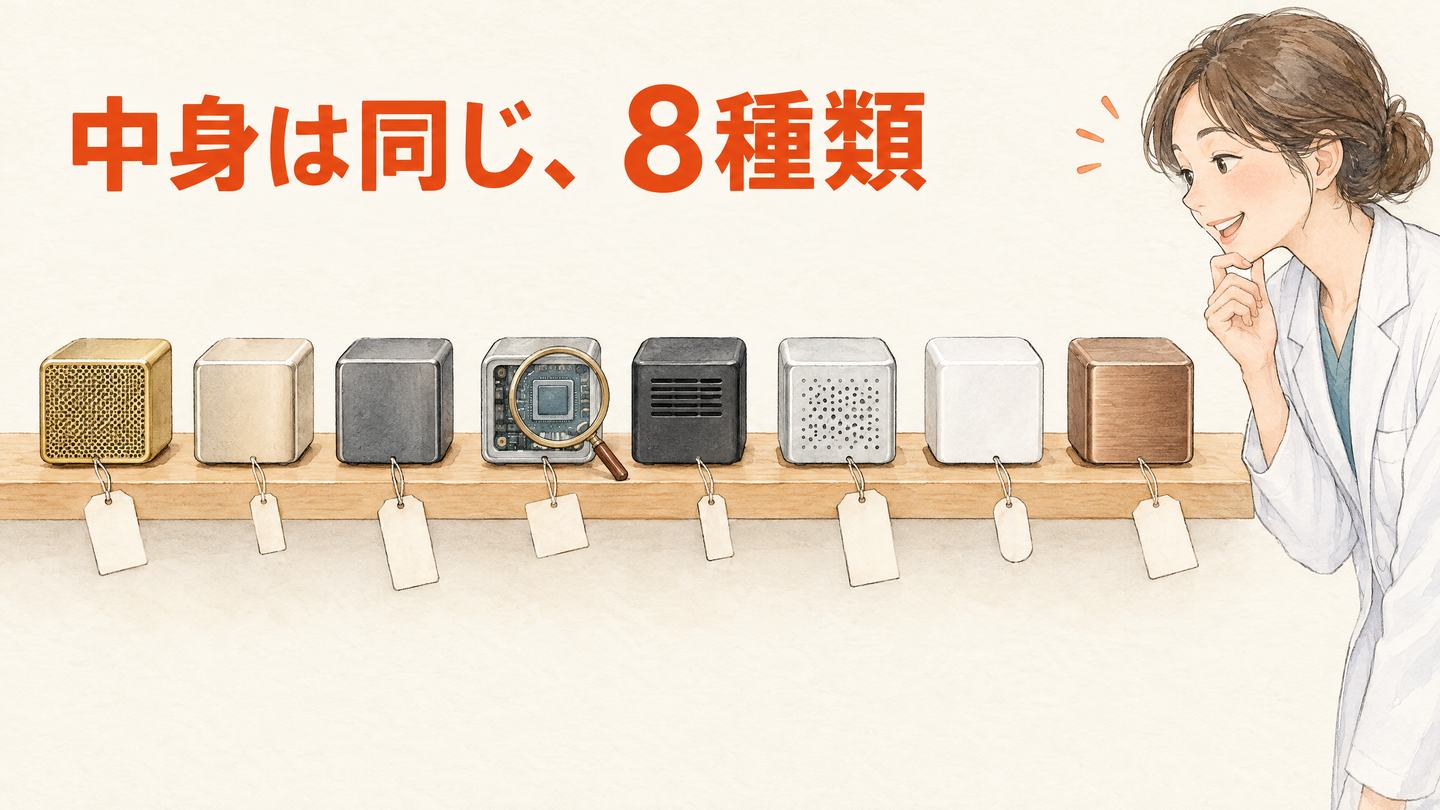
「あのなDGX Sparkって8種類あんねん」と、7月にXで投稿しました。NVIDIA純正とOEM 7社で、計8種類あります。中身のチップは全部同じGB10で、128GBのメモリも150×150×51mmの弁当箱サイズも共通です。違うのは筐体とSSDだけです。10月19日時点の国内最安値を、7月の参考価格と並べました。
| 製品 | SSD | 10月19日の国内最安(税込) | 7月6日(参考) |
|---|---|---|---|
| ① NVIDIA DGX Spark(Founders Edition) | 4TB(Gen5) | 在庫なし(10月14日の最終掲載は1,199,800円) | 約110万円から |
| ② ASUS Ascent GX10 | 1TB / 2TB(Gen4)、4TB(Gen5) | 1,079,980円(1TB、ドスパラ) | 1TB約109万円(価格.com)、約84.5万円(Amazon) |
| ③ MSI EdgeXpert | 1TB / 4TB、4TB(Gen5) | 1,415,750円(4TB Gen5、ASKダイレクト) | 1TB約113万円、4TB約123万円 |
| ④ Dell Pro Max with GB10 | 1TB / 2TB / 4TB(Gen4) | 1,238,520円(4TB、価格.com) | 法人見積のみ |
| ⑤ HP ZGX Nano G1n | 2TB / 4TB(Gen4) | 1,298,000円(4TB、HP直販) | 法人見積のみ |
| ⑥ Lenovo ThinkStation PGX | 1TB / 4TB(Gen4)ほか | 1,210,000円(1TB) | 約85.9万円から(価格.com) |
| ⑦ GIGABYTE AI TOP ATOM | 4TB(Gen5)、2TB(10月16日発売) | 1,198,000円(4TB、アプライド) | 約123万円から(価格.com) |
| ⑧ Acer Veriton GN100 | 4TB(Gen4) | 2,081,093円(Amazon) | 約200万円(Acer直販) |
価格は10月19日時点の店頭表示で、日々変わります。7月6日の欄は著者のXへの投稿の参考価格です。
70万円以下で買える128GBの機種は、もうありません。いちばん安いのはASUS GX10の約108万円で、いちばん高いAcerは200万円を超えます。中身は同じなので、こだわりがなければ安い機種で十分です。
DGX Sparkは計算性能が高く、同じモデルで比べると、長い文書の読み込みはM3 Ultraの約2倍の速さです。ただし、メモリ帯域幅はMac Studioより狭いので、生成の速さではMac Studioのほうが上です。Qwen3.8-Flash-Nextは載りますが空きメモリがほとんど残らないので、Qwen3.8-27BやGemma 4 31Bを、vLLMで院内の数人に提供する使い方が合っています。なお、StrataはDGX Sparkを対応機種に挙げていません。
2. DGX Spark(64GB版)
10月23日から、OEM 6社が売り出します(米国価格は4,999ドルから、国内価格は未発表)。チップも帯域幅も128GB版と同じで、メモリだけが半分です。
Qwen3.8-Flash-Nextは載りません。使えるのは、30B前後のモデル(Qwen3.8-27BやGemma 4 31B)を院内の数人で使う場合と、あとで複数台をつなぐ前提の場合です。
3. Mac Studio(M5世代)
9月にM5 MaxとM5 Ultraの機種が出て、Apple Siliconの弱点だった長い文書の読み込みが、M3世代の2倍以上速くなりました。
- M5 Ultra(256GB、1,669,800円):4bit版がそのまま載り、長い文書もいちばん快適です。
- M5 Max(128GB、887,800円):Strataと組み合わせて、1人で使う1台としていちばんバランスのいい構成です。
- M3 Ultraを持っている人:買い替えを急ぐ必要はありません。不満が出るのは、長い文書を渡すときだけです。
4. ゲーミングPC+Strata
ゲーミングPCを持っているなら、メモリを64GBに増やしてStrataを試すのが、いちばん安い始め方です。RTX 5070とメモリ64GBを新しく買っても、GPUとメモリで約25万円です。
ただし、いまはメモリが高く、DDR5の128GB(64GB×2枚)は約40万円と、RTX 5070(約15万円)の2倍以上します。2025年9月の約9倍です。新しく組むのは、お金に余裕があれば検討してもいいかもしれません。組むなら、メモリは64GBか96GBで足ります。RTX 5090は品薄で店頭100万円前後(案内価格は393,800円)なので、今は買う時期ではありません。
プリフィルとデコード
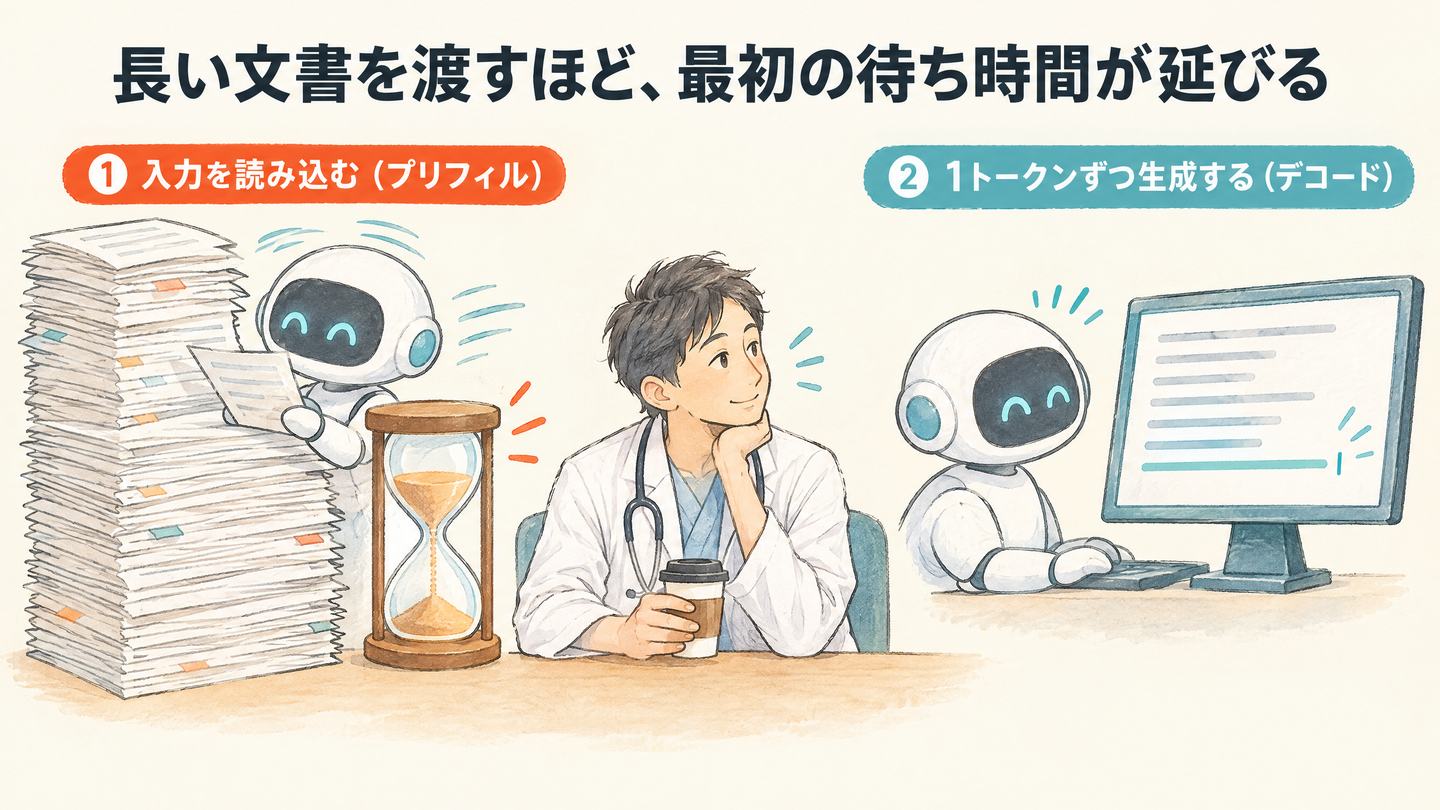
LLMの待ち時間は、2つの段階に分かれます。
- プリフィル(入力の読み込み):渡された文章をまとめて計算します。速さはGPUの計算性能で決まります。
- デコード(生成):1トークンずつ出力します。速さはメモリ帯域幅で決まります。
短い質問なら、プリフィルは一瞬で終わります。カルテや経過記録を数万トークンまとめて渡す医療の使い方では、プリフィルが使い勝手を決めます。
3万トークン(日本語で約4万字)を渡したときの、生成が始まるまでの時間
クラウドのAIに慣れた人がローカルLLMを遅いと感じるのは、たいてい長い文書を読み込む待ち時間です。
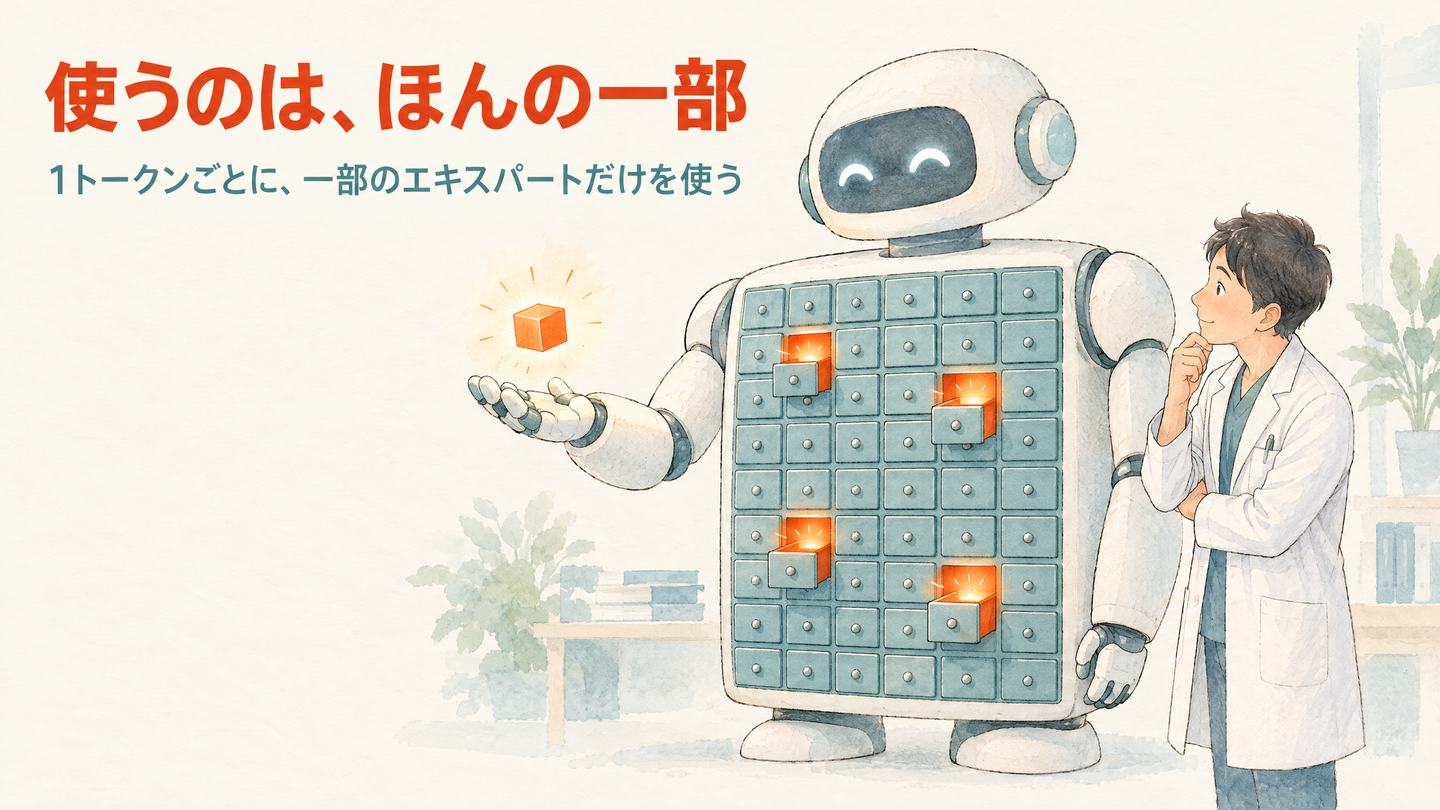
5月の記事では、1トークンごとにモデルの全パラメータを読むとして、gpt-oss-120bの生成速度をDGX Sparkで毎秒4〜5トークンと計算していました。これは誤りです。gpt-oss-120bやQwen3.8-Flash-NextはMoEという構造で、1トークンを出すのに使うのは、全体の数%だけです。読む量が少ないので、帯域幅が控えめなDGX Sparkでも、gpt-oss-120bを毎秒50トークン前後で生成します。
モデル
5月の記事で紹介したQwen3.5は、8月に公開されたQwen3.8の世代に置き換わりました。1人ならQwen3.8-Flash-Next、複数人ならGemma 4 31BかQwen3.8-27Bが中心になります。
| モデル | 総パラメータ(1トークンで使う量) | ライセンス | 4bitの大きさ | 合うマシン |
|---|---|---|---|---|
| Qwen3.8-Flash-Next | 1,250億(約60億) | Qwen Community License 1.0 | 約94〜120GB | M5 Ultra 256GB。Strataを使えばM5 Max 128GBやゲーミングPC |
| Gemma 4 31B | 310億(すべて) | Apache 2.0 | 約18GB | 24GB以上のGPU、DGX Spark 64GB版、64GB以上のMac |
| Qwen3.8-27B | 270億(すべて) | Apache 2.0 | 約16GB | 24GB以上のGPU、DGX Spark 64GB版、64GB以上のMac |
| DeepSeek-V4-Flash | 2,840億(130億) | MIT | 約137〜155GB | DGX Spark 2台、M5 Ultra 256GB |
| DeepSeek-V4.1-Flash-1017(10月17日) | 7,630億 | MIT | 約500GB | 1台には載らない |
4bitの大きさは、Unslothなどが配布している量子化版のファイルサイズです。
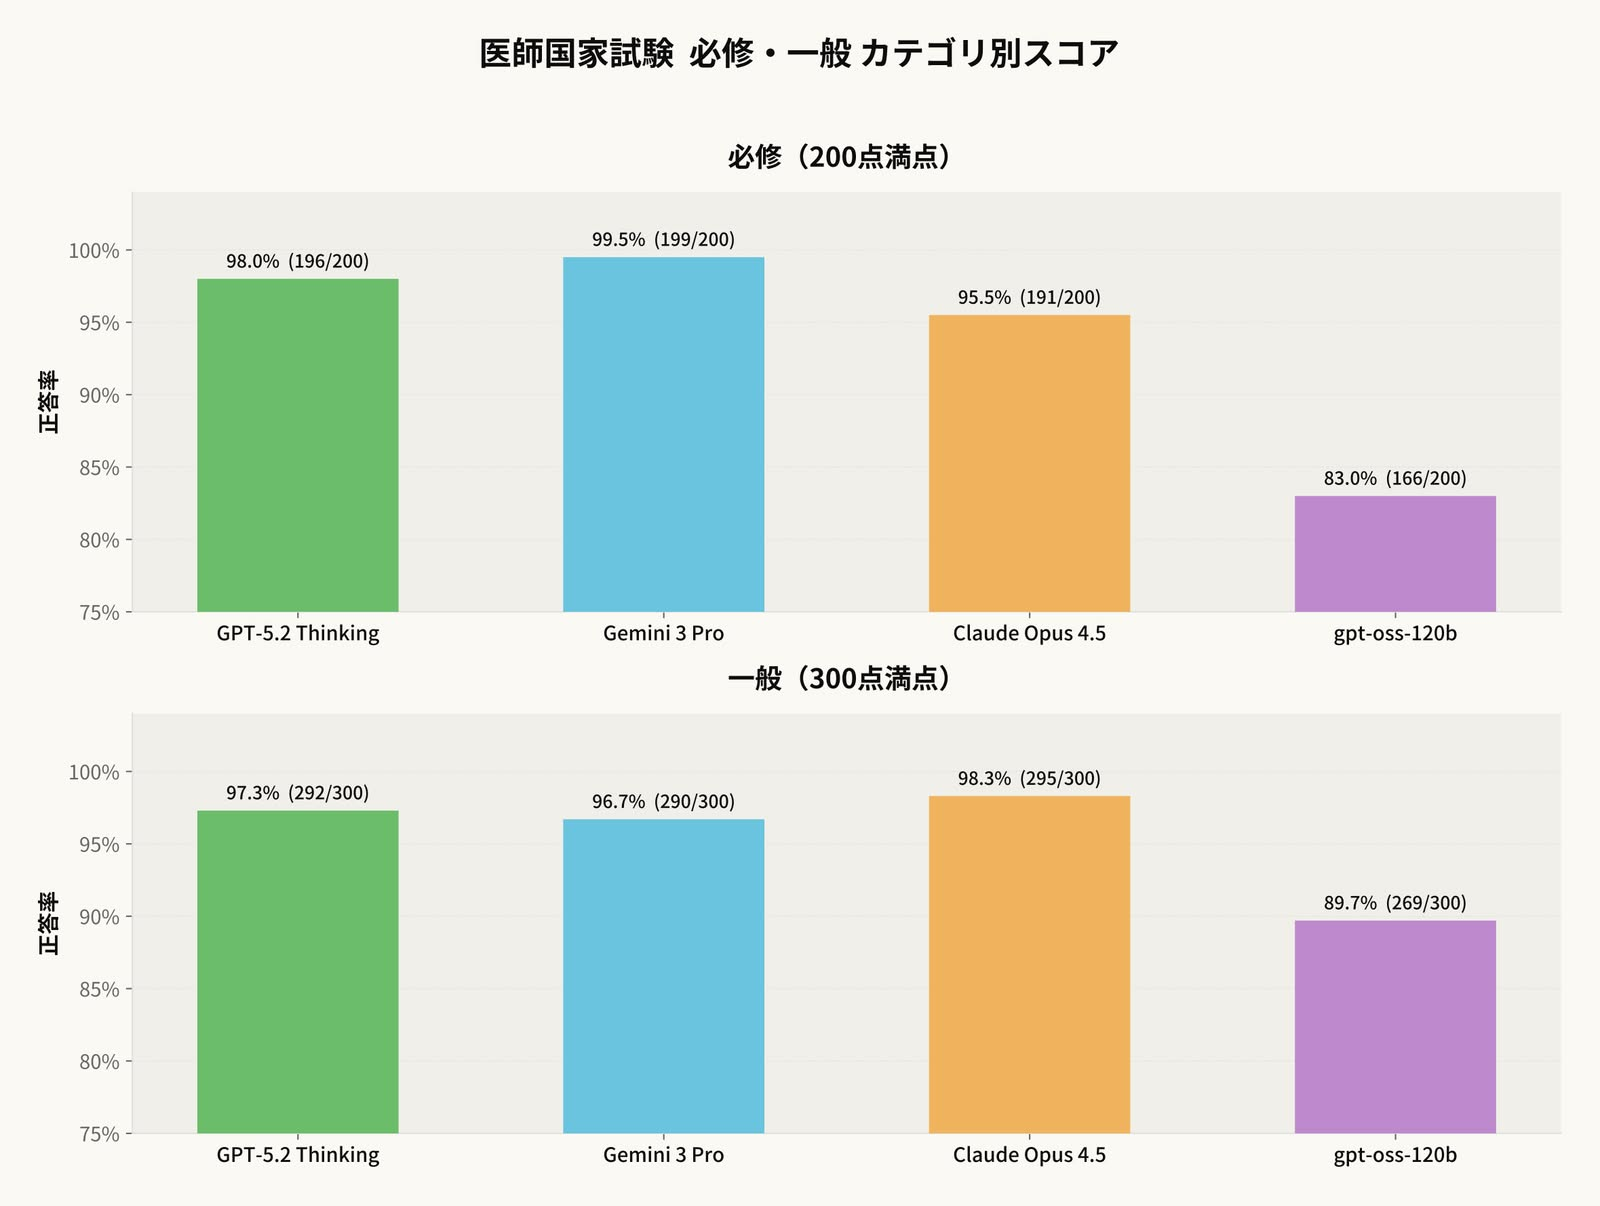
医師国家試験から作られたベンチマーク(JMedQA)でも、Qwen3.8-Flash-NextとGemma 4 31Bは正答率94%台で、5月の記事で使ったgpt-oss-120b(88.6%)を上回っています。Gemma 4 31Bは小さめのモデルなので、軽い構成で医療に使いたい場合の有力な候補です。
Qwen3.8-Flash-Nextのライセンスは、独自のQwen Community License 1.0です。商用利用はできますが、モデルをAPIなどで外部に提供する事業や、コーディングや事務作業向けのAIアシスタント事業では、別のライセンスが要ります。院内だけで使う分には、別途の契約は要りません。
DeepSeekなど、もっと大きなモデル
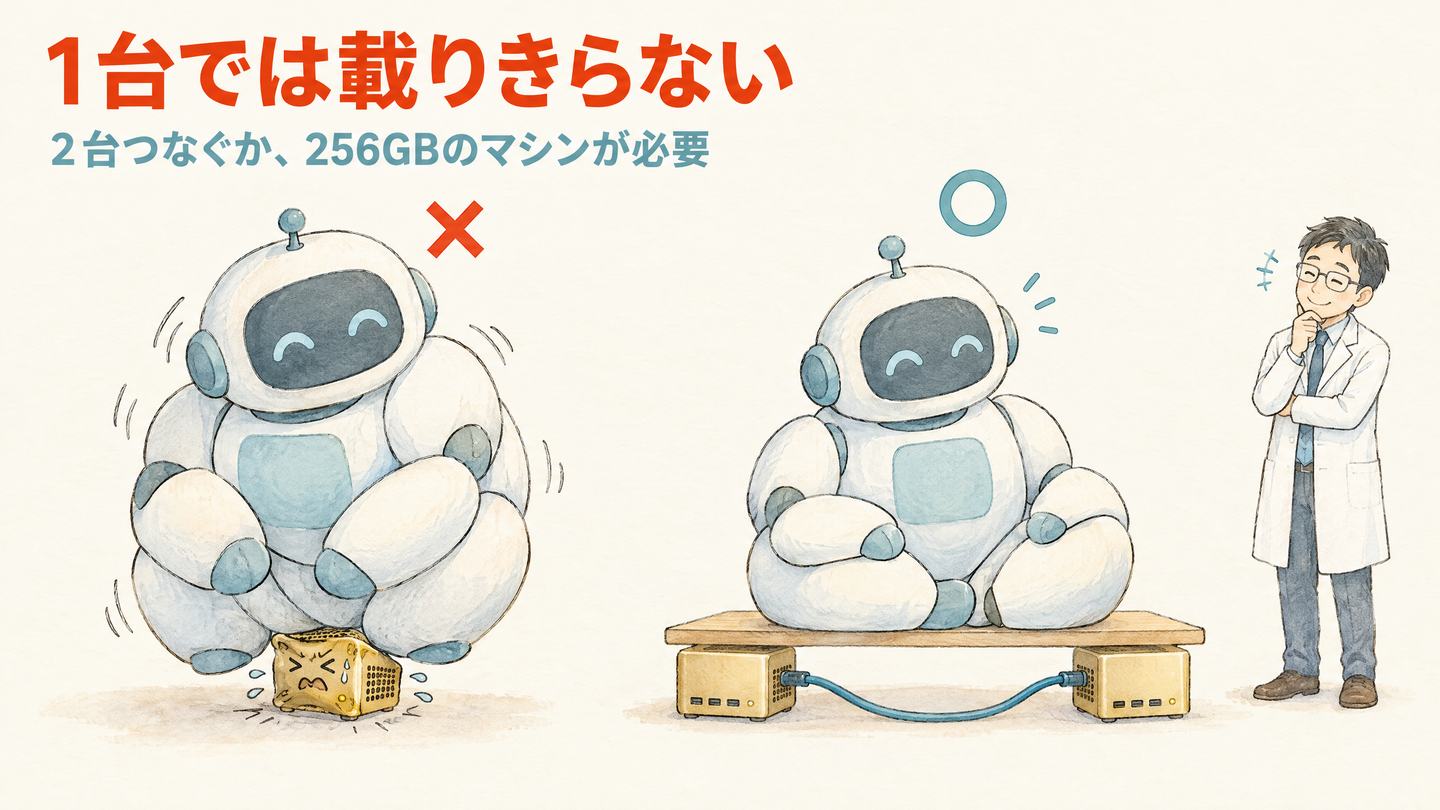
DeepSeek、GLM、MiniMax、Kimiも大きなモデルを公開しています。DeepSeekを4bitで動かすなら、DGX Spark 1台では足りません。DeepSeek-V4-Flashは4bitでも150GB前後あり、DGX Sparkを2台つなぐか、256GBのMac Studio M5 Ultraが要ります。10月17日に出た最新のDeepSeek-V4.1-Flash-1017は、4bitで約500GBあり、1台には載りません。正直、手元で動かすのは厳しいです。Strataも、いまのところDeepSeekには対応していません。
推論ソフトとこの半年の流れ
- 1人で使う:手軽さならLM Studio、小さなGPUで大きなモデルを動かすならStrataです。
- 院内の数人で使う:vLLMかSGLangに、Open WebUIをつなぐ構成を勧めます。
Ollamaは手軽ですが、標準では1件ずつ処理するので、院内の共用には向きません。
推測デコード
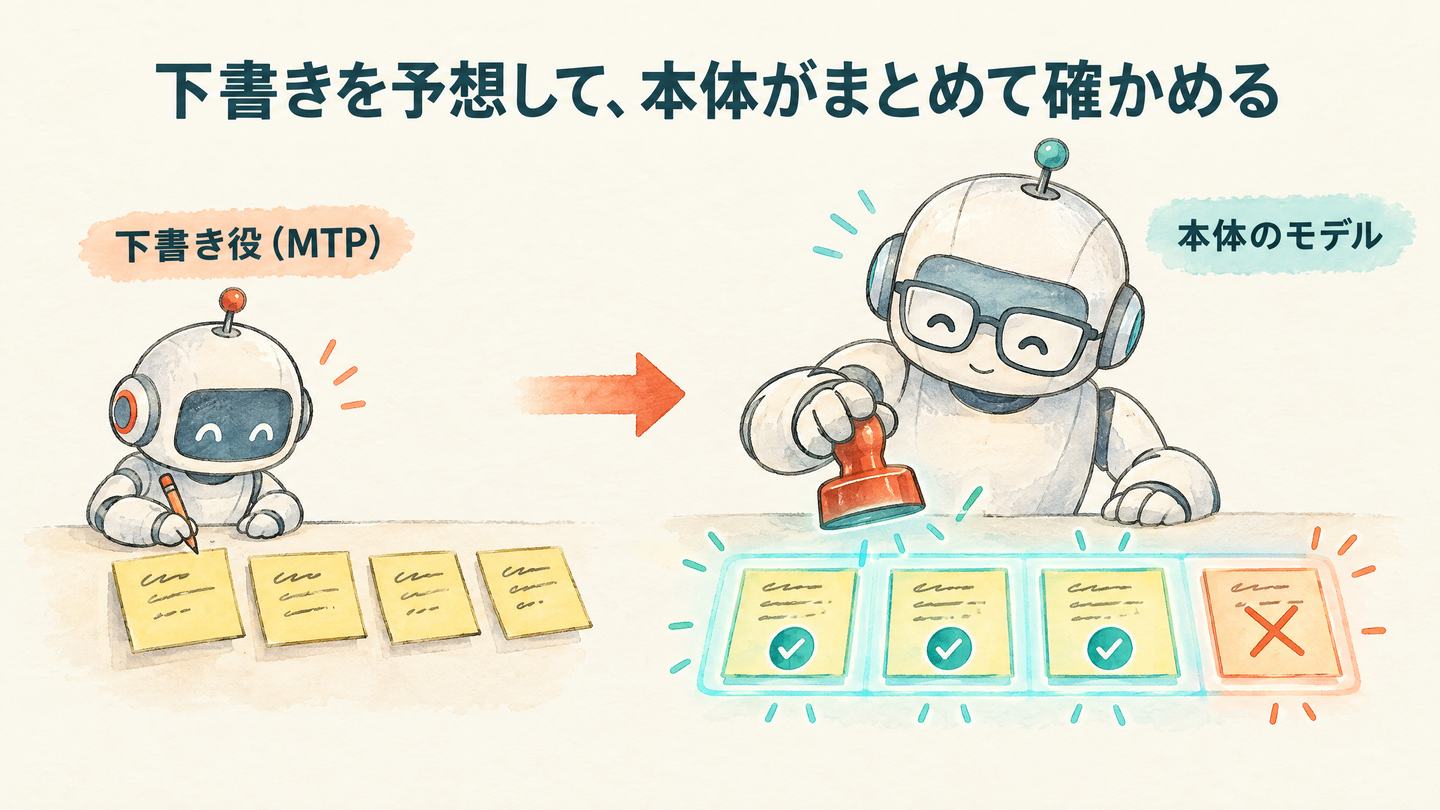
いま多くの推論エンジンに入りつつあるのが推測デコードです。小さな下書き役が次の数トークンを予想し、本体のモデルがまとめて確かめるので、ハードを変えずに生成が速くなります。10月には、RTX 3090でQwen3.8-27Bが最大4.6倍速くなった例がXで話題になりました。カルテの文言を引き写す退院サマリーのような作業は、特に効きやすいです。
実測:Mac Studio M3 Ultra(96GB)+Strata
手元のMac Studio(M3 Ultra、96GB)に、Strata(v0.1.44.1)とQwen3.8-Flash-Next(IQ3_S)を入れて測りました。モデルは外付けSSDに置き、普段の仕事のアプリを開いたままです。10月19日に出たv0.2.0-betaでは、Mac向けにもそのまま入れられるアプリ(.dmg)が配布されています。
| 項目 | 結果 | 所見 |
|---|---|---|
| 生成速度(短い質問) | 毎秒約70トークン | 快適 |
| 生成開始まで(短い質問) | 0.5秒 | 待ちはほぼなし |
| 生成開始まで(4Kトークン、日本語で約5,000字) | 5.6秒 | 許容範囲 |
| 生成開始まで(16Kトークン、約2万字) | 20.5秒 | 少し長い |
| 生成開始まで(32Kトークン、約4万字) | 41.5秒 | はっきり長い |
| 起動 | 初回157秒、2回目以降43秒 | 外付けSSDから読み込むため |
| 退院サマリー(入力1,500字、出力600字) | 思考オフ11.5秒、low 23秒、highは96秒たっても終わらず | 文書作成ならlow |
分かったこと
- 長いカルテで待たされる:短い質問は快適ですが、3万トークンを超えると読み込みだけで40秒前後かかります。
- 96GBはぎりぎり:生成中は空きメモリが減り、ほかのアプリが追い出されました。普段使いのMacと兼用するなら、余裕はありません。
- 思考の設定はlowに:既定のhighでは、600字の退院サマリーでも考え続けて終わりませんでした。lowがちょうどよく、思考オフでは事実の誤りが1か所あったので、医師の確認は外せません。
まとめ
1人で使うならMac Studio M5 Max 128GBとStrata、院内の数人で使うならDGX Spark 128GBとvLLMが、いまの私の候補です。ゲーミングPCを持っているなら、メモリを64GBに増やしてStrataを試すのが、いちばん安く始められます。
ハードの値段は上がり続けていますが、推論ソフトは毎週のように速くなっています。新しいハードを買う前に、手持ちのマシンで最新の推論エンジンを試してみてください。状況が大きく変わったら、また書き直します。
GENSHI AIは、ハードウェアの選定からモデルの検証、院内システムとの連携、運用まで、ローカルLLMの導入を支援しています。ご関心のある方は、お気軽にお問い合わせください。
※価格は2026年10月19日時点の国内価格(税込)です。速度は各出典の計測条件で大きく変わるので、目安として見てください。当社の実測は2026年10月19日に、Mac Studio(M3 Ultra、GPU 60コア、96GB、macOS 26.5.2)、Strata v0.1.44.1、Qwen3.8-Flash-Next IQ3_Sで行いました。
参考資料
- Strata(GitHub、Niko1221/Strata)
- Strata v0.2.0-betaのリリースノート(2026年10月19日)
- Qwen3.8-Flash-Next モデルカード(Hugging Face)
- jmedqa-eval(JMedQAでの評価結果、2026年10月17日更新)
- NVIDIA Blog:DGX Spark 64GB(2026年10月2日)
- PC Watch:DGX Spark 64GB版の発表と価格改定(2026年10月2日)
- llama.cpp:DGX Sparkでのベンチマーク
- llama.cpp:gpt-ossの機種別ベンチマーク(M3 Ultraほか)
- NVIDIA Developer Forums:DGX Spark 1台でのQwen3.8-Flash-Next 4bit
- Apple Newsroom:M5 Max / M5 Ultra搭載のMac Studio(2026年8月25日)
- MacStories:M5 Ultra Mac Studio のレビュー
- insiderllm:Strata と llama.cpp の比較(RTX 3090)
- vLLM:macOSでのインストール(CPUのみ対応)
- HyperQwen(GitHub、RTX 3090での推測デコード)
- AKIBA PC Hotline!:メモリ価格の月例調査(2026年10月15日)
- 著者のXへの投稿:DGX Sparkの8種類(2026年7月6日)
- 厚生労働省:医療情報システムの安全管理に関するガイドライン 第7.0版